AIが書いたテストは、AIの解釈しか証明しない ― テストの重心が移る日
AIが書いたテストは、AIの解釈しか証明しない ― テストの重心が移る日
この記事でわかること
- テストまでAIに書かせると、なぜ「全部green」が品質の証明にならないのか(仕様の解釈をAIが黙って決めてしまう、3つの具体的な失敗パターン)
- ミューテーションテスト・文脈外レビュー・人間の判断、それぞれの守備範囲
- その上で、検証の重心をどこに置き直すか
PHP/Laravel の小規模検証アプリ(テスト12本:初回生成の11本+検証の過程で追加した1本)による実験記録です。記事用に作成したもので、実案件のコードではありません。
検証環境は PHP 8.4.7 / Laravel 12.69.1 / PHPUnit 11.5.56(php artisan test で実行)です。実装とテストの生成には Claude Opus 5 を使いました。
はじめに
こんにちは。DIVXの堀次です。
AIにAPIを1つ書かせました。モデル、コントローラ、テスト11本。全部green。ここまで数分です。
では、このコードは本番に出していいのでしょうか。
私は即答できませんでした。1行ずつ読めば判断できるのかもしれませんが、この量が毎日出てくる前提だと、読み切ること自体が現実的ではありません。しかも自分が書いていないコードを読むコストは、自分で書いたものを読み返すより明らかに高いです。
かといって「テストが全部通っているので大丈夫です」と言い切るのも、少し気が引けます。そのテストも、同じAIが書いているからです。
では何を根拠に「これは大丈夫だ」と判断すればいいのか。ひとつの候補として思い浮かんだのが、テスト駆動開発(TDD)でした。「何をもって正しいとするか」を先に決めてから作る——この発想自体は、書き手が人間かAIかに関係なく成立しそうに思えます。本当にそうなのか、実際に手を動かして検証してみることにしました。
やってみてすぐに分かったのは、従来のTDDをそのまま持ち込んでも噛み合わない、ということでした。小さな単体テストを1本書いては通し、また1本書いては通す——という作法は、人間が1行ずつ実装を書くという前提の上に組み立てられているからです。
この記事は、その組み立てを一度ばらして考え直してみた記録です。仮に「現代版TDD」と呼んで進めます。
仮説: 検証の重心はどこに置くべきか
従来のTDDは、検証の重心を単体テストに置くという考え方を前提にしてきました。単体テストを大量に積み上げ、結合テストで層をつなぎ、E2Eは「本当に全部繋がっているか」を最後に薄く確認するだけ、という考え方です。これは、人間が実装を1行ずつ手で書いていた時代には合理的でした。
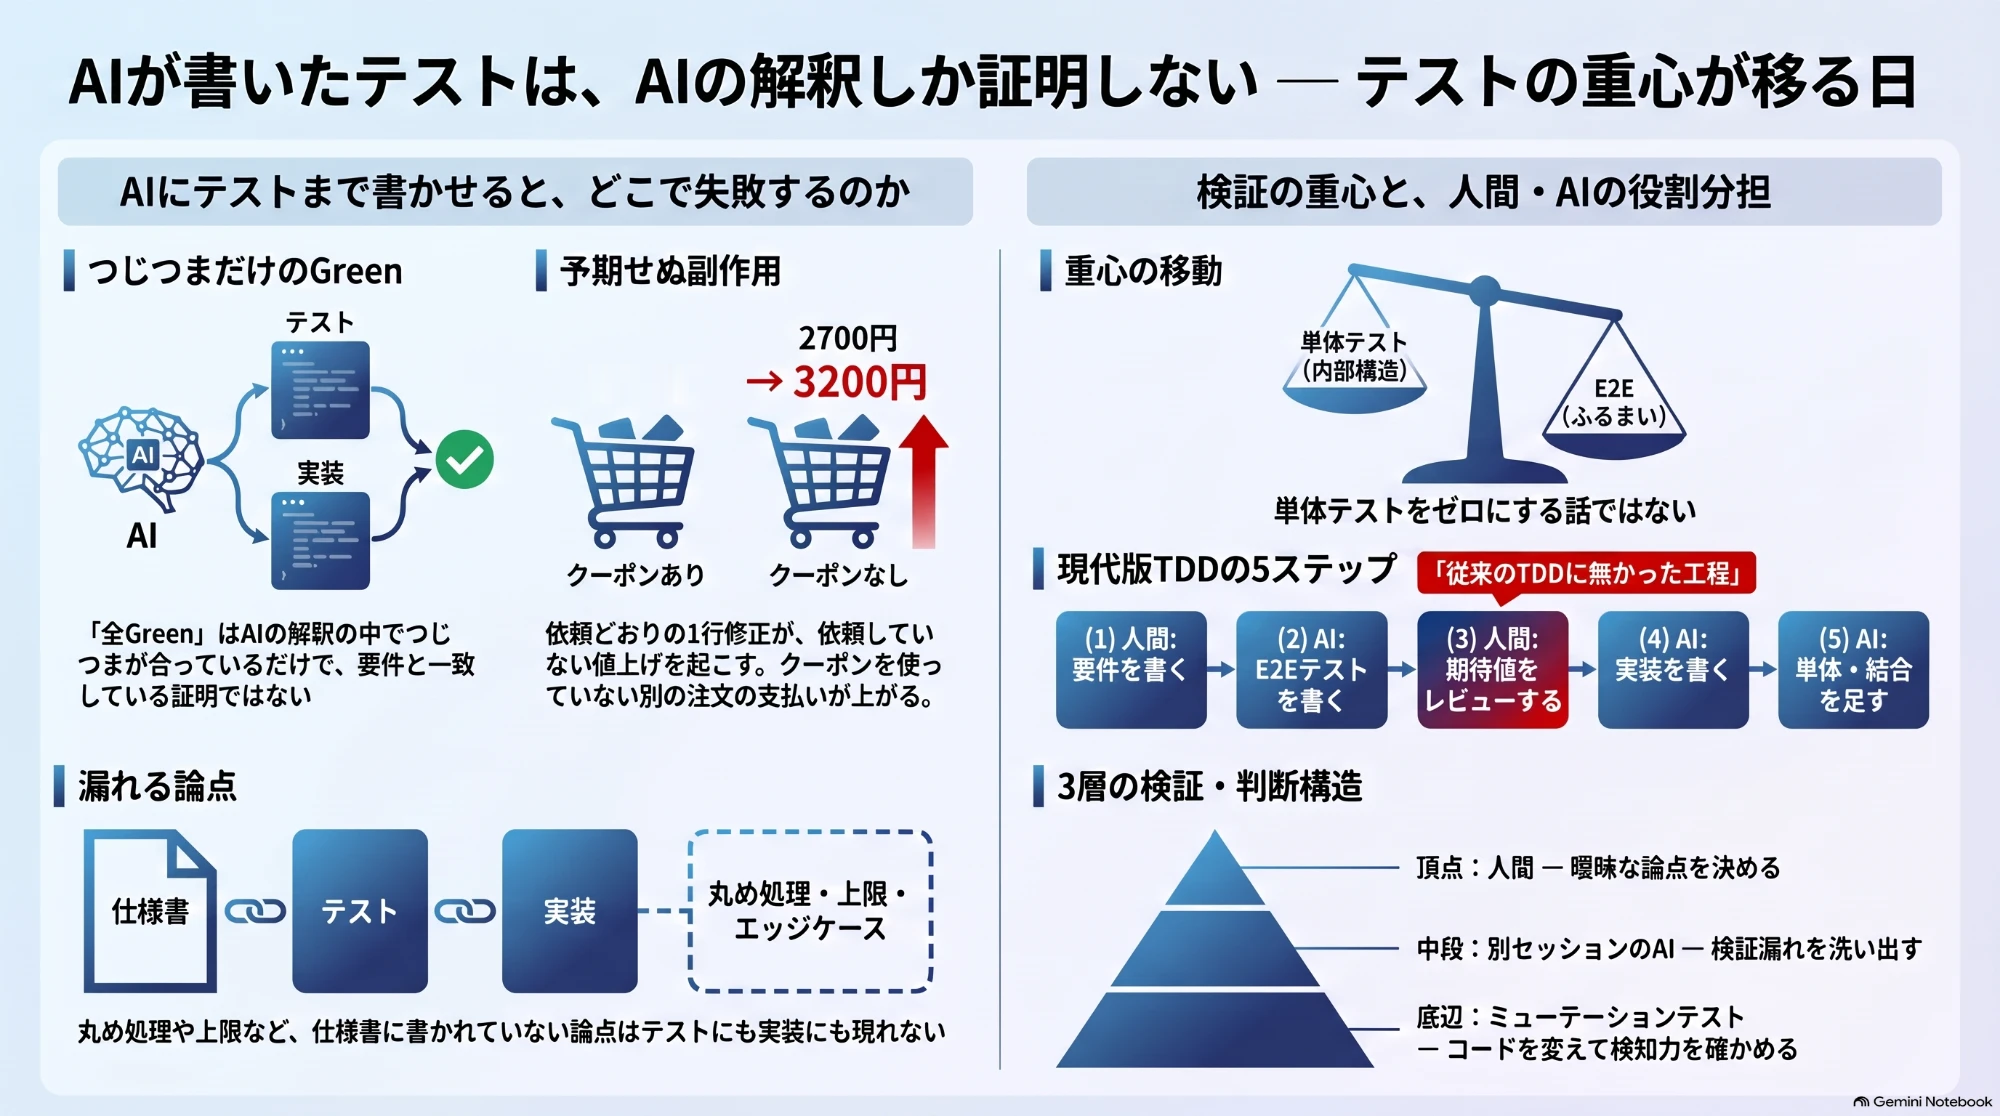
しかし、AIが実装のかなりの部分を代わりに書くようになった今、この重心はE2E側に移るのではないか、と考えています。
層 | 従来の重心 | AI時代の重心 |
|---|---|---|
単体テスト | ■■■■■■■■ ← 重心 | ■■ |
結合テスト | ■■■■ | ■■■■ |
E2E | ■■ | ■■■■■■■■ ← 重心 |
ただ、これは机上の予想でしかありません。本当にこの比率でテストが書けるのか、そしてどこで失敗するのかを確かめるために、小さなPHP/Laravelアプリを1つ作って実測しました。ここから先は、その記録です。
作ったもの
「会員ランクとクーポンから注文の支払い金額を計算する」という、よくあるEC機能を題材にしました。
POST /api/quote
  → QuoteController        … HTTP層
      → Member::findOrFail() / Coupon::active()->where(...)   … DB層
          → OrderPricingService::calculate()                   … 純粋な算術ロジック
要件は、次の自然言語の仕様書(SPEC.md)だけを与えました。
今回は失敗パターンを観察するのが目的なので、あえて人間側での確認を一切挟まず、このメモだけを渡してAIにテストと実装を一括生成させました。途中で「ここはどう解釈すればいいですか」と聞かれることもなく、そのまま出てきます。
出てきたE2Eテストは、こういう形です。
public function test_シルバー会員_有効クーポンあり_送料無料(): void
{
    $member = Member::factory()->silver()->create();
    Coupon::factory()->create(['code' => 'WELCOME500', 'discount_amount' => 500]);

    $response = $this->postJson('/api/quote', [
        'member_id' => $member->id,
        'subtotal' => 5000,
        'coupon_code' => 'WELCOME500',
    ]);

    $response->assertOk()->assertJson(['total' => 4250]);
}
そして、計算の中身はこれだけです。
public function calculate(int $subtotal, float $discountRate, int $couponDiscount): int
{
    $afterRankDiscount = (int) round($subtotal * (1 - $discountRate));
    $afterCoupon = max(0, $afterRankDiscount - $couponDiscount);

    // 送料の判定は「割引前」の商品合計で行う
    $shipping = $subtotal >= self::FREE_SHIPPING_THRESHOLD ? 0 : self::SHIPPING_FEE;

    return $afterCoupon + $shipping;
}
この10行に、仕様書には書かれていない判断が3つ埋まっています。①会員割引とクーポンのどちらを先に引くか、②マイナス床止めは商品代だけか送料込みか、③送料判定は割引前か割引後か。どれも仕様書を読んだだけでは決められないので、AIが勝手に決めました。
ちなみに②は、生成されたテストの名前にだけ痕跡が残っていました。「少額注文でクーポンを使うとマイナスにならず0円で床止め」というテスト名ですが、実際の期待値は送料込みの500円です。テスト名と期待値の間に解釈が挟まっていて、名前だけ読むと取り違えます。
この記事の後半は、このうち③と、そもそもこのリストにすら挙がらなかった4つ目の論点を巡る話になります。
① なぜ検証の重心はE2Eへ移動するのか
AIが書き終えたテストの内訳は、こちらから比率を指定したわけでもないのに、自然にこうなりました。
tests/Feature/QuoteApiTest.php      (E2E・実HTTP+実DB)   … 8本
tests/Integration/CouponActiveScopeTest.php(結合)        … 2本
tests/Unit/OrderPricingServiceTest.php(純粋ロジックのみ)  … 1本

Tests: 11 passed (18 assertions)
Duration: 0.19s
E2Eが最も厚く、単体が最も薄くなりました。これが成立する理由は3つあります。
理由1: 人間が検証すべき対象が変わった
単体テストは「実装の内部がどう動くか」を検証します。しかし人間がAIに実装を委ねた瞬間、その「内部の動き方」は人間が書いたものではなくなります。人間が本当に確認しなければならないのは「AIが書いたコードの内部が正しいか」ではなく、「AIがこちらの意図を正しく理解したか」という一点になります。
意図は実装の細部には現れません。「金額を送ったら、いくら返ってくるか」という振る舞いにしか現れません。だからこそ検証の重心は、振る舞いをそのまま確認できるE2Eに寄ります。
理由2: E2Eを書くコストが下がった
従来E2Eが少なかったのは、実行が遅い以上に、書くのが面倒だったからです。DBのfixture、認証、HTTPリクエストの組み立て——これを1本書く手間で単体テストは3〜4本書けました。
今回、E2E用にMember::factory()->gold()->create()のようなfactoryをAIに用意させるコストは、単体テスト用のモックを用意するコストとほぼ変わりませんでした。「E2Eは高コスト」という前提そのものが、人間の手作業を前提にした話だったとわかります。
理由3: 実行速度のボトルネックが移動した
従来、単体テストが好まれた理由の一つは「1行書いてすぐ実行し、フィードバックを得る」というループの速さでした。しかし今、人間の編集単位は「1行」ではなく「自然言語で仕様を渡し、AIが1機能分を書く」という大きな塊になっています。この粒度では、テスト1本が5msか50msかはほとんど誤差でしかありません。
実際、SQLiteをテストDBに使えば、DBを介するE2Eを8本含めても11本で0.19秒でした。「E2Eは遅いから最小限に」という制約は、少なくとも今回の規模では成立しませんでした。
従来のTDDと、何が入れ替わったのか
ここまでを踏まえて、今回やったことを手順の形に整理してみます。私の場合は、結果としてこの5ステップになりました。
1. 自然言語で要件を書く                                  (人間)
2. 要件を「具体的な入力と出力の組」に変換し、E2Eテストにする (AI)
3. E2Eテストの期待値を人間がレビューする                   (人間)← 従来のTDDに無かった工程
4. そのテストが通る実装を書く                             (AI)
5. 結合・単体は、E2Eで担保しきれない部分にだけ足す         (AI)
従来のTDDとの違いは3点あります。
テストの粒度が変わります。 「1メソッドに1テスト」ではなく「1つの振る舞い(1リクエスト)に1テスト」。red→greenのサイクルが、メソッド単位ではなく機能単位になります。
テストを書く主体が変わります。 人間ではなくAIが書きます。人間が担当するのは、テストを書くことではなく、書かれたテストの期待値を承認することです。
人間のレビュー対象が変わります。 実装コードではなく、E2Eテストの期待値です。assertJson(['total' => 2200])の「2200」という数字が自分の意図と合っているか、そこを見ます。今回試した限りでは、ここが人間の手を抜けない一点だと感じました。
逆に言えば、ステップ3を飛ばすとどうなるか。次章は、実際に飛ばしてみたときに何が起きたかの記録です。
② 失敗はどこで起きるのか
テストコードもAIに書かせている以上、失敗は「実装のバグ」としてではなく「テストと実装が仲良く間違っている」という形で現れます。実際に手を動かして踏んだ3つを、順に並べます。
失敗1: 全部green ≠ 要件と一致
これが一番重要で、実際に埋め込んだまま気づかなかった例があります。
public function test_ゴールド会員_クーポンあり_送料無料境界ちょうど(): void
{
    // 送料判定は割引前の3000円で行う、という解釈
    $response->assertOk()->assertJson(['total' => 2200]);
}
仕様書の「送料は合計金額が3000円以上で無料」という一文には、割引「前」の金額を見るのか、割引「後」の金額を見るのかが書かれていません。AIは割引前と解釈し、その解釈でテストと実装の両方を揃えました。つまりこのgreenは、自己無矛盾の証明でしかありません。もし本来の意図が「割引後の金額で判定」だったなら、正解は2200円ではなく2700円になります。
11本のテストは全部greenでしたが、これは要件と一致しているかどうかとは無関係でした。
失敗2: 依頼どおりの1行修正が、依頼していない値上げを起こす
失敗1に気づいた人間が、こうAIに指示したとします。
送料の判定、割引後の金額でやってほしいです。直してください。
一見、正しい修正依頼です。実際にこの1行だけ直してみました。
- $shipping = $subtotal >= self::FREE_SHIPPING_THRESHOLD ? 0 : self::SHIPPING_FEE;
+ $shipping = $afterCoupon >= self::FREE_SHIPPING_THRESHOLD ? 0 : self::SHIPPING_FEE;
結果、落ちたテストは2本でした。
⨯ ゴールド会員 クーポン無し 送料無料の境界      total: 2700 → 3200
⨯ ゴールド会員 クーポンあり 送料無料境界ちょうど  total: 2200 → 2700
2本目は依頼どおりです。問題は1本目です。クーポンを使っていないゴールド会員が3000円ちょうどを買ったときの支払いが、2700円から3200円に上がっています。人間はクーポン併用時の話しかしていないのに、クーポンと無関係な注文の送料まで有料になりました。
ここから先は試していませんが、構造上こうなり得ます。AIに「1本目も落ちてます」とだけ伝えれば、期待値を3200に書き換えることで全部greenに戻せてしまいます。そうなると、誰も承認していない値上げが、テストがgreenであることを根拠に確定します。
テストと実装を両方同じAIに書かせている以上、食い違ったときにどちらが正しいかを機械的に判定する方法はありません。「落ちたテストを直す」ではなく「落ちたテストの期待値が、今も自分の意図と合っているか」を人間は毎回見るしかありません。
失敗3: 「広く浅く」になり、仕様に書かれていない論点が丸ごと抜ける
書き上がった8本のE2Eテストのうち、実際に金額を計算している7本(残り1本はバリデーションエラーの確認)で使われた金額を並べてみます。
2000円 / 3000円 / 5000円 / 300円 / 3000円 / 2000円 / 2000円
全部、割引率を掛けても端数が出ない数字です。つまりこの8本は、端数処理の仕様を一度も踏んでいません。
仕様書には端数について一言も書かれていませんでした。書かれていないので、AIはround()=四捨五入を勝手に選び、その選択を検証するテストも書きませんでした。そして生成物に目を通した時点でも、私はそれを拾えませんでした。書かれていない論点は、テストケースにも現れないのです。
あとから端数の出るケースを1本足してみます。
public function test_割引で端数が出るケース(): void
{
    $member = Member::factory()->gold()->create();

    // 1005 * 0.9 = 904.5 → 四捨五入なら905、切り捨てなら904
    $response = $this->postJson('/api/quote', [
        'member_id' => $member->id, 'subtotal' => 1005,
    ]);

    $response->assertOk()->assertJson(['total' => 1405]); // 905 + 送料500
}
これを足してテストは12本になりました。そして新しい1本は、現在の実装(四捨五入)で問題なくgreenになります。ですがもし経理側の要件が「顧客有利に切り捨て」だったなら、1円ずつ、全ての端数取引でズレ続けます。しかも元の8本は、その間ずっとgreenのままです。
失敗1が「書かれているが曖昧な一文」の話だったのに対し、これは「そもそも書かれていない論点」の話です。前者はレビューで気づける可能性がありますが、後者はテストにも実装にも姿を現さないので、業務知識を持った人間が「端数どうする?」と外から問いを持ち込むまで、永久に発見されません。
技法: 解釈をコメントで可視化する
対策として有効だったのは、曖昧な判断をした箇所にその場で解釈をコメントに残させることでした。
// 送料判定は割引前の商品合計で行う
$shipping = $subtotal >= self::FREE_SHIPPING_THRESHOLD ? 0 : self::SHIPPING_FEE;
このコメントが無ければ、レビューする人間は「なぜ2200円なのか」を追うために実装を読み解く必要があります。コメントがあれば、その1行を見るだけで「これは解釈であり、確認が必要な箇所だ」とすぐ分かります。AIに実装させる際は「判断が分かれる箇所には理由をコメントで残すこと」を明示的に指示するとよいでしょう。
③ では、レビューもAIにやらせればいいのでは?
ここまで読むと、当然こう思うはずです。「テストの期待値を人間がレビューする、と言っているが、そのレビューもAIにやらせればいいのでは?」
もっともな疑問だと思います。そして実際、AIによるレビューはかなり有効です。今回の失敗のうち、失敗3(端数処理の穴)は、AIレビューで十分に見つかる類のものでした。仕様とテストを渡して「この仕様に対して検証されていない論点を挙げて」と聞けば、端数・上限値・タイムゾーン・同時実行あたりは高い確率で返ってきます。人間より網羅的なくらいです。
なので「レビューは人間の専任業務だ」とは思っていません。ただ、いくつか区別しておきたいことがあります。
ミューテーションテスト: 誰の意見も聞かない検査
まず、AIに問う以外の方法があります。ミューテーションテストです。実装の一部をわざと壊して、テストがちゃんと落ちるかを確認する手法です。
今回の実装で試しました。専用ツールは使わず、手で1箇所だけ書き換えています。四捨五入を切り捨てに変えます。
- $afterRankDiscount = (int) round($subtotal * (1 - $discountRate));
+ $afterRankDiscount = (int) floor($subtotal * (1 - $discountRate));
最初に書いた8本のE2Eテストを、この壊した実装に対して走らせた結果です。
✓ 一般会員 クーポン無し 送料あり
✓ ゴールド会員 クーポン無し 送料無料の境界
✓ シルバー会員 有効クーポンあり 送料無料
✓ 少額注文でクーポンを使うとマイナスにならず0円で床止め
✓ ゴールド会員 クーポンあり 送料無料境界ちょうど
✓ 期限切れクーポンは無効として扱われる
✓ 存在しないクーポンコードは無視される
✓ 存在しない会員idは422で拒否される
8本とも通りました。 ミューテーションテストの言い方をすれば、変異体が生き残った状態です。丸め方を変えても、このテストスイートは何も気づきません。
この手法が強いのは、誰の意見も聞かないからだと思っています。「このテストで十分ですか?」とAIに問えば、書いた本人と同じ前提が返ってくる可能性があります。でも、ミューテーションテストは推論しません。壊して、気づくかどうかを見るだけです。だから共有された思い込みをすり抜けられません。
同じ文脈で書いたテストは、なぜ通ってしまうのか
生成されたテストを後から眺めていて、2つの傾向に気づきました。
1つ目。選ばれた金額が、全部きれいな数字でした。
2000 / 3000 / 5000 / 300
AIが意図的に端数を避けたわけではないと思います。ですがテストと実装を1回の生成でまとめて書くと、期待値は計算しやすい数字で組み立てられます。そして計算しやすい数字とは、まさに四捨五入と切り捨ての差が出ない数字です。結果として、自分が無言で決めた判断を暴けないテストスイートが出来上がりました。手を抜いたのではなく、構造的にそうなった。だから厄介だと感じています。
2つ目。期待値が独立に導出されていません。 5000 * 0.95 - 500 = 4250という計算は、生成の過程で1回しか行われていないはずです。その1回の結果が、テストのassertJsonにも実装の設計にも、両方に書き込まれています。テストは実装の検算ではなく、実装計画の転記です。この構造では、greenは検証の結果ではなく前提条件になります。
だとすると、レビューをAIに任せる場合も、同じ文脈の中で自己レビューさせても効きにくいはずです。文脈を切って渡す、別のモデルに投げる、「この実装の問題点を挙げよ」という敵対的な聞き方にする——このあたりを挟んで初めて、レビューとして機能し始めるのだと思います。
それでも埋まらない一点
ただ、ここまで積んでも埋まらない場所が1つ残ります。
失敗3(端数処理が抜けている)  → ミューテーション・敵対レビューで機械的に炙り出せる
失敗1(2200円か2700円か)      → 何段重ねても出てこない
round→floorの変異体が生き残るという事実は、業務要件が切り捨てだった場合でも全く同じように観測されます。ミューテーションテストは穴の在り処を教えてくれますが、どちらが正解かは教えてくれません。
同じことがAIレビューにも言えて、「ここは割引前とも割引後とも読めます」までは到達できますが、「だから2200が正しい」には到達できません。仕様書にもテストにも実装にも、その答えが書かれていないからです。存在しない情報は、どんな検査手法でも取り出せません。
整理すると、こういう層になっている気がしています。
何を担保するか | 手段 | 誰がやるか |
|---|---|---|
テストが変更を検知できるか | ミューテーションテスト | 機械 |
検証されていない論点は何か | 文脈外・敵対レビュー | AI |
曖昧な論点をどう決めるか | — | 人間 |
一番下だけが人間に残る、という理解です。そしてこれは「AIには難しいから人間が」ではなく、情報がまだどこにも存在しないので、誰かが決めるしかない、という種類の残り方だと思っています。
仕様書は、渡して終わりの書類ではなかった
ここまでの話を、最初のSPEC.mdに引き戻して考えてみます。
私はあの仕様書を「AIに渡すための入力」として書きました。ちゃんと書けば、あとはAIが正しく実装してくれるはず——という前提です。でも実際には、あの仕様書には端数処理の記述がありませんでした。しかも「書き忘れた」のではなく、そういう論点があること自体を思いついていなかったのです。
これは自分にとって、今回いちばん意外だった点でした。決めるのは人間の仕事だと思っていたのに、そもそも何を決めなければいけないのかを、人間の側も把握できていなかったわけです。
そう考えると、「人間が要件を固めてからAIに渡す」という順番のイメージは、実態と合っていない気がします。私の場合、実際に起きたのはこういう往復でした。
不完全な仕様書を書く
  ↓
AIが実装とテストを書く(このとき、書かれていない論点は勝手に埋められる)
  ↓
ミューテーションや文脈外レビューで「勝手に埋められた箇所」が浮かび上がる
  ↓
そこで初めて「端数、どうする?」という決め事が発生する
  ↓
仕様書に1行増える
仕様書は最初に完成させるものではなく、AIと往復しながら少しずつ穴が埋まっていくもの——今回に限って言えば、そういう性質のものでした。だとすれば、実装が終わった時点で仕様書が初稿のままなら、それはまだ誰も気づいていない決め事が残っているサインなのかもしれません。
④ 人間は何に注意すべきか
ここまでを踏まえて、現時点で私が意識しておきたいと思っているのは、次の8つです。
- 曖昧な仕様は、実装前に具体的な数字の例で確認します。 「送料は3000円以上で無料」ではなく、「ゴールド会員がクーポンを使って合計3000円ちょうどの場合、送料はどうなりますか」まで踏み込んで確認します。文章のままでは曖昧さは可視化されません。
- 仕様に「書かれていない論点」を、業務知識の側から持ち込みます。 端数処理、タイムゾーン、上限値、同時実行——これらは仕様書に書かれないまま実装され、テストにも現れません。「この計算に端数は出るか。出るならどちらに丸めるか」という問い自体を、ドメインを知っている人間が外から入れる必要があります。
- 「全部green」を鵜呑みにせず、E2Eテストの期待値そのものをレビューします。 コードを読むのではなく、
assertJson(['total' => 2200])の2200という数字が、自分の意図と一致しているかを確認します。ここがAI時代のコードレビューの中心になると思っています。 - テスト自体の検知力を、書いた文脈の外から検査します。 ミューテーションテストで「壊しても気づかない箇所」を機械的に洗い出し、レビューは別モデル・別文脈・敵対的な問い方で回します。同じ文脈での自己レビューは、同じ思い込みを再生産しがちです。
- AIに、判断が割れた箇所をコメントで明示させます。 「なぜこの値になったか」が埋もれていると、レビューは実装を読み解く作業に逆戻りします。
- 単体テストはゼロにしません。 重心が移っても、単体テストが消滅するわけではありません。特殊な算術・アルゴリズムなど、AIの実装そのものに固有のロジックが宿る箇所は、引き続き単体で固定しておきます。
- セルフヒーリングを「広さの穴」の言い訳にはしません。 昨今のE2Eはセルフヒーリング(表記や内部実装が変わっても、意味が同じなら自動で追従する仕組み)によって保守コストを抑えられるようになってきました。しかしそれが吸収するのは「壊れやすさ」だけで、「そもそも想定していない論点のテストが存在しない」という穴は埋めてくれません。壊れないテストが増えることと、検知力が上がることは別物です。
- 人間の役割は「コードを読む人」から「意図を確認する質問をする人」に寄っていきます。 実装の細部を追う代わりに、曖昧さを先回りして質問する力の方が、これからのレビューでは価値を持つのではないかと思っています。
まとめ
今回試したのは、小さなアプリ1つ・テスト12本(初回生成が11本、検証の過程で1本追加)という、ごく限られた範囲の実験です。これだけで一般論を言い切れるとは思っていません。ただ、実際に手を動かしてみて感じたことを、現時点の考えとして書いておきます。
E2Eをどこまで厚くするかは、おそらくそれほど本質的な問いではないのだろうと思いました。今回いちばん強く感じたのは、人間とAIの間で、自然言語の要件がどれだけ正確に一致しているか、結局そこに全部が乗っかっているということでした。
テストが全部greenでも、それは「AIが自分で決めた解釈の中で一貫している」ことの証明でしかなく、要件と合っているかどうかは別の話でした。そして、その一致を人間が確認できる場所は、実装の細部(単体テスト)ではなく振る舞い(E2Eテスト)の側にありました。だから重心がE2Eに寄っていくのではないか、というのが今の私の見立てです。
とはいえ、重心が移ること自体が目的ではないとも思っています。目的は変わらず「意図した通りに動くこと」を確認することで、AIの時代にはそれを確認できる層がE2E側にある、というだけの話なのかもしれません。
そして、そのE2Eの検証すらAIに任せられる部分は、これからさらに増えていくと思います。穴を見つける仕事はどんどん機械の側に寄っていくはずです。ただ、見つかった穴をどう埋めるかを決めるところだけは、当分こちら側に残るのではないか——今のところ、そんなふうに考えています。
DIVXでは、AIが書いたコードやテストをどう検証するかの設計や、既存プロジェクトのテスト戦略の見直しといったご相談もお受けしていますので、お気軽にお声がけください。